
12GB GPU дээр 125B загварыг 100 tok/s хурдаар: "Strata" хөдөлгүүр орон нутгийн AI-ийн дүрмийг өөрчиллөө

Хиймэл оюуны томоохон хэлний загваруудыг (LLM) өөрийн компьютер дээр орон нутагт (locally) ажиллуулахыг хүсдэг инженер бүрийн өмнө нэгэн том саад үргэлж тулгардаг: VRAM-ийн дутагдал. Хэрэв та 70B эсвэл 120B+ хэмжээтэй загвар ажиллуулахыг хүсвэл олон ширхэг дата төвийн A100 эсвэл H100 карт түрээслэх шаардлага гардаг. Харин энгийн GPU дээр RAM руу "offload" хийх үед хурд нь 2-5 tokens/sec болж шалдаа буудаг билээ.
Гэвч энэ гацааг нээлттэй эхийн шинэ төсөл болох Strata үндсээр нь эвдэж, Hacker News болон хөгжүүлэгчдийн нийгэмлэгийг шуугиулж эхэллээ. Тэд хэрэглэгчийн түвшний ердөө 12GB-24GB VRAM-тай видео карт (RTX 4090, 5070 зэрэг) болон энгийн 64GB DDR5 RAM дээр 125 тэрбум параметртэй Qwen3.8-Flash-Next загварыг 94–100 tokens/sec хурдтайгаар ажиллуулах шийдлийг гаргаж иржээ.
Асуудлын гол: MoE загвар ба PCIe-ийн түгжрэл
Орчин үеийн хамгийн хүчирхэг загварууд ихэвчлэн Mixture of Experts (MoE) архитектуртай байдаг. Тухайлбал, 125 тэрбум нийт параметртэй Qwen3.8-Flash-Next загварын хувьд токен тус бүрийг боловсруулахад нийт жингийн ердөө ~6 тэрбум параметр (цөөн тооны "expert") л идэвхждэг.
Гэсэн хэдий ч 125B загварын нийт санах ойн багтаамж quantize хийсэн ч 50-80GB болдог. Уламжлалт хөдөлгүүрүүд (жишээ нь энгийн llama.cpp тохиргоо) VRAM-д багтахгүй экспертүүдийг PCIe шинээр дамжуулан GPU рүү зөөх гэж оролддог. Үр дүнд нь PCIe bandwidth бүрэн ханаж, тооцоолол биш "өгөгдөл зөөх ажиллагаа" системийн гол гацаа болж хувирдаг байв.
Strata-ийн нууц: Гурван шатлалт санах ой ба CPU параллелизм
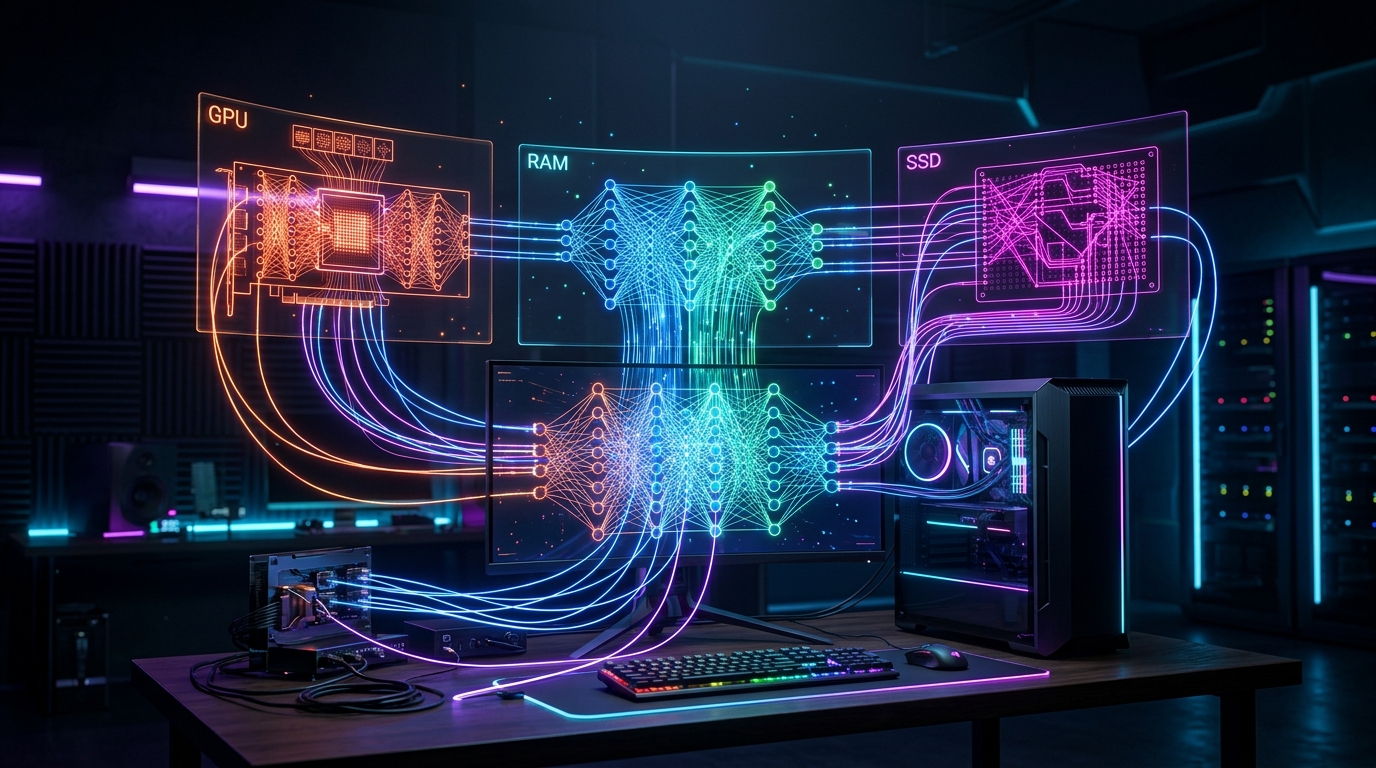
Strata хөдөлгүүр нь уг асуудлыг санах ойн гурван түвшний шатлал (Three-Tier Hierarchy) болон ухаалаг хуваарилалтаар шийджээ:
- Hot Tier (VRAM - 12GB+): Загварын бүх токенд зайлшгүй ашиглагддаг суурь dense давхаргууд (Attention механизм, LayerNorm) болон хамгийн их ашиглагддаг экспертүүдийг динамик "Expert Cache"-д байрлуулна.
- Warm Tier (Системийн RAM - 64GB DDR4/DDR5): Бүх 24,576 экспертийг энд байлгана. Хамгийн гол инновац нь: GPU кэшэд байхгүй экспертийг PCIe-ээр GPU рүү чирч авчрахын оронд CPU дээр шууд зэрэгцүүлэн тооцоолдог (Parallel Compute over PCIe swapping). Орчин үеийн 8-16 цөмт CPU-ийн SIMD/AVX зааварчилгааг дайчилснаар өгөгдөл зөөвөрлөх хугацааг бүрэн халжээ.
- Cold Tier (NVMe SSD): Том хэмжээний n-gram lookup хүснэгтийг хадгалах бөгөөд санах ойн ачааллыг дахин бууруулахад тусалдаг.
Үүн дээр нэмээд загварын өөрийнх нь Multi-Token Prediction (MTP) болон Speculative Decoding логикийг гүн интеграцчилснаар бүрэн forward pass хийх давтамжийг эрс цөөлж, 100 tok/s гэх өмнө нь төсөөлөхийн аргагүй хурдад хүрсэн байна.
Хөгжүүлэгчид өөрийн машиндаа юу хийж чадах вэ?
Энэ нь зүгээр нэг лабораторийн туршилт биш бөгөөд шууд практикт ашиглах бэлэн экосистемтэй ирж байна:
- OpenAI болон Anthropic нийцтэй API: Strata нь
localhostдээр стандарт REST API үүсгэдэг. Та Cursor, Claude Code, Cline, Aider зэрэг дурын хөгжүүлэлтийн агентдаа холбоход л хангалттай. - Үүлэн үйлчилгээнээс хараат бус, 0 төлбөр: Токен бүртээ доллар төлөх, хурдны хязгаарлалт (rate limit)-д унах, кодын нууцлалаа гуравдагч этгээдэд алдах эрсдэл бүрэн үгүй болно.
- 128k–262k Контекст цонх: Урт код бааз бүхий төслүүдтэй ажиллах том хэмжээний контекстийг 4-bit KV Cache-ийн оновчлолтойгоор дэмждэг.
Бид хиймэл оюуны хөгжүүлэлтэд "зөвхөн үүлэн дата төв л ажиллаж чадна" гэсэн монопол төсөөллөөс гарч, орон нутгийн тоног төхөөрөмж дээр архитектурын түвшинд ухаалаг систем бүтээх эрин рүү шилжиж байгааг уг төсөл бэлхнээ харуулж байна.
Хэрэв та өөрийн RTX 3090/4090/5070 картаа 125B хэмжээтэй coding agent болгон хувиргахыг хүсвэл тус төслийн GitHub сангаас нэг товшилтоор ажиллуулах скриптийг туршаад үзээрэй.
Эх сурвалж: Niko1221 / Strata Engine (GitHub) болон Hacker News: Run Qwen 3.8 Flash Next on consumer hardware.
Сэтгэгдэл
Ачаалж байна...